如题所示,我来骗token了。
在电脑里仿真mcu一直是一件很好玩具有教育意义的事情 翻译过来就是只能用来教学用,不具备生产价值
所以我用ai和我对在pc上仿真mcu固件的全部积累胡乱写了个demo
(叠甲:只是ai写的demo。源码。)
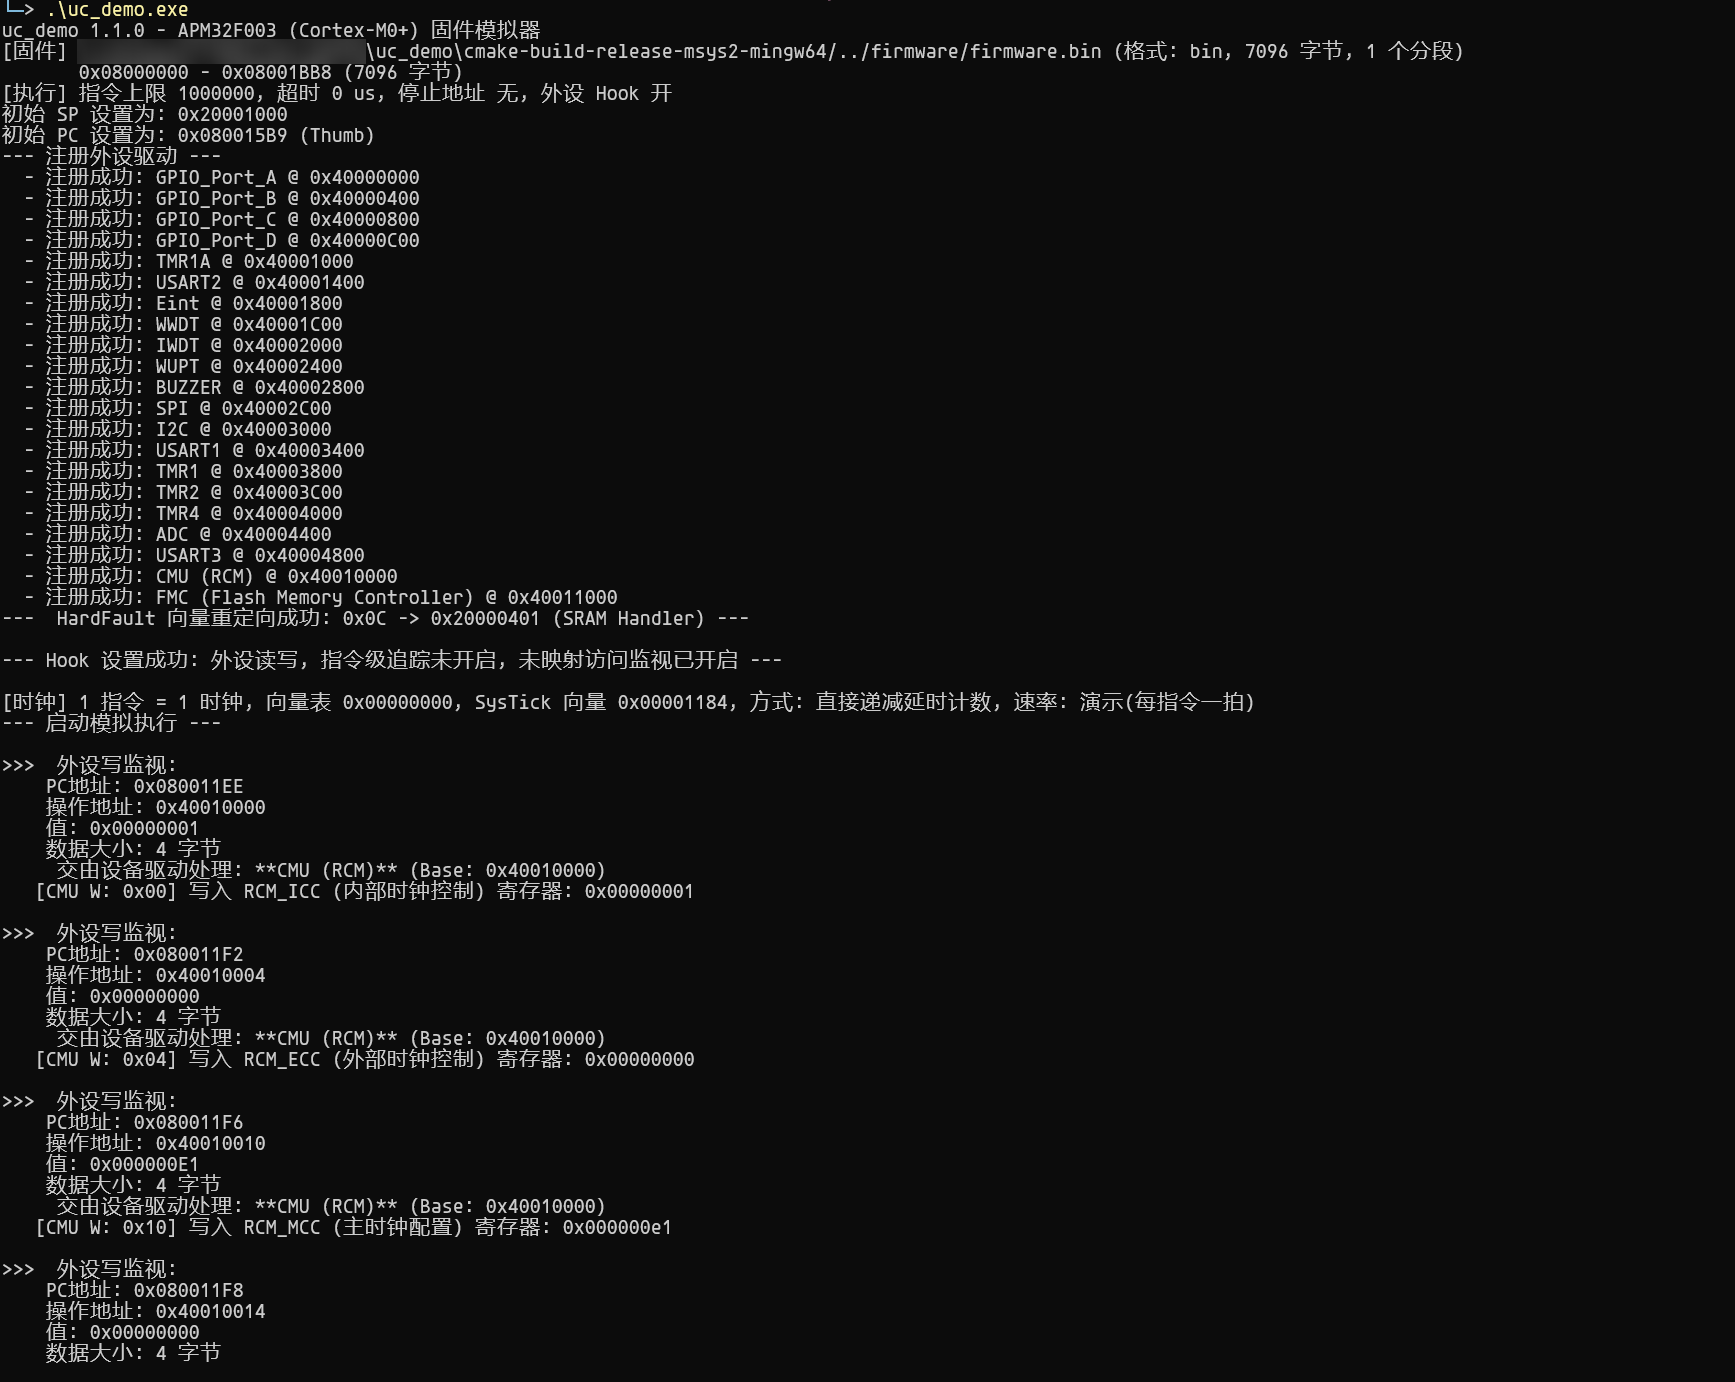
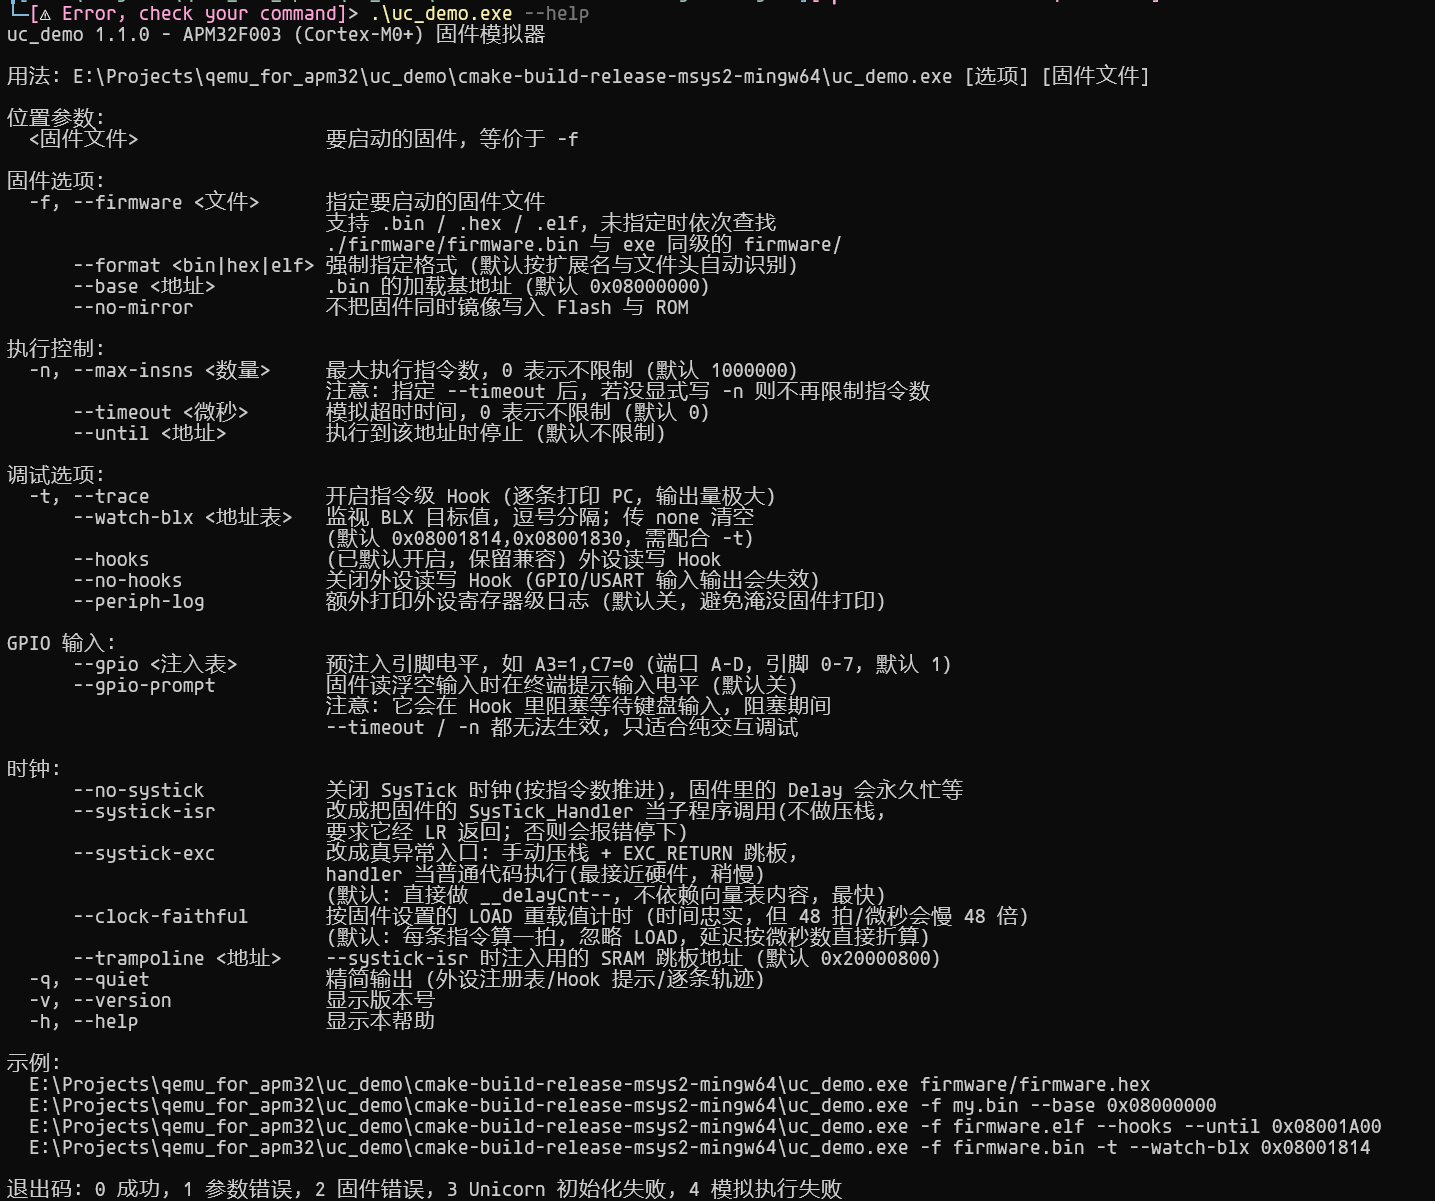
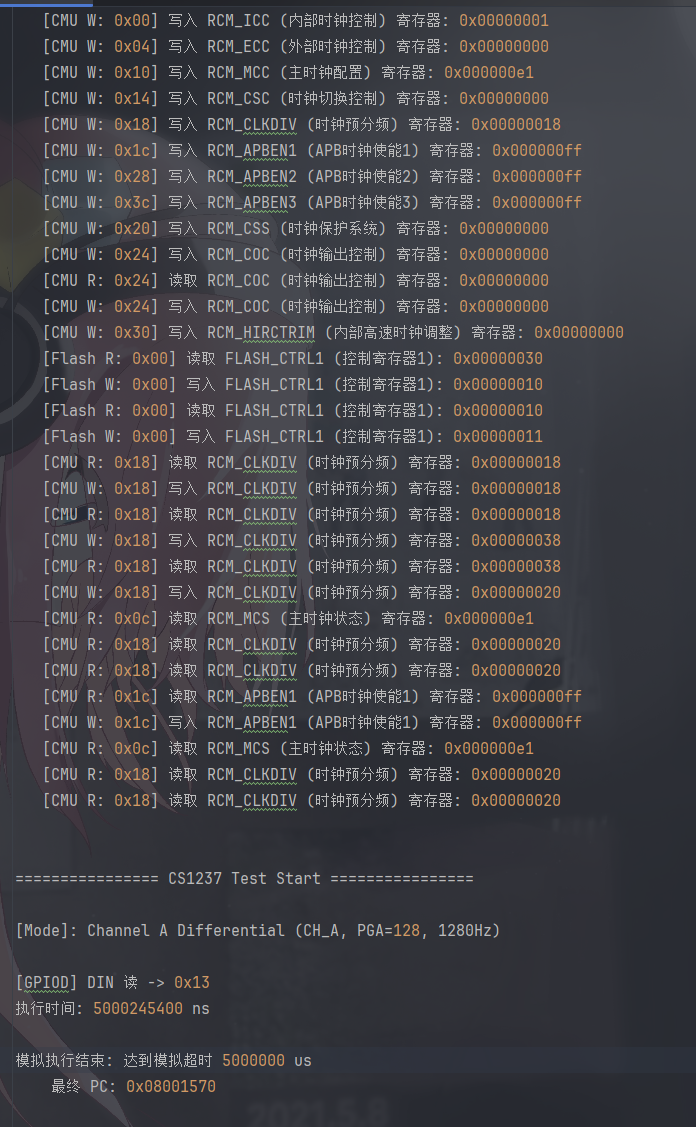
建议使用ai生成命令运行。
(饺子醋:
最后:我想骗token用,如果想让我写完完整的模拟器,请给我token,谢谢。
其它的碎碎念:
- 这其实只是很丑陋的对unicorn的使用,本质是利用unicorn的arm m0二进制执行能力执行固件,通过unicorn提供的hook来模拟硬件外设。
- 其实我有更好的实现方案,比用unicorn更好 当然请给我token谢谢!有token我才能让ai教会我写graalvm truffle 。
- 我不相信ai写的代码,至少如果不是我具体每一行都审核都看过的代码我是不相信的。所以别相信这个demo的源码。
- 这个demo的时钟理论上应该是按照1条指令一个时刻推进的,但是参考3,鬼知道ai怎么写的。
- 5. 其实就算没有token我也会自己买。
- 对了,RCM_HIRCTRIM 的副作用是什么?用户手册只说了RCM_HIRCTRIM能微调频率,RCM_HIRCTRIM对主频的影响比例是多少?
- 其实模拟一个mcu在现代pc上并不难,解决了二进制翻译问题就是纯体力活,实现一个又一个外设。
- 我说的话其实都是废话,因为你读的时候根本理解不了,你缺少至少数十MB的文本资料补充。
- 说到二进制翻译,用ghird的seligh引擎去把二进制翻译成统一的中间表示–pcode。
- 针对pcode写一个解释执行器或者更牛逼的带jit的执行器都是可行的路径。
- 所以我的选择是使用graalvm的truffle框架,利用其允许让自定义语言运行在jvm之上的能力。
- 利用truffles的demo其实我也早就拿ai车出来了。技术可行性是没有问题的。
- 13. 为什么是jvm,因为jvm是世界上最屌的vm。
- 其实这个项目没有多少意义,这个项目所建模mcu模型太理论了,太虚假了,即使去和spice混合仿真也没有用处,很难去复现真实的硬件行为。
- 真正能复现mcu的模拟器应该是厂商的那啥Verlagio模型,但那玩意不是我等能接触的。
- 16. 我废话真多。
- 关于加速,解释执行总是慢的,所以jvm有用于jit的c1,c2。所以对于要手动实现解释执行的一定要在后期引入jit。
- 关于jit可以进一步aot,即静态翻译,但是静态翻译不好解决动态跳转,:
/**
* startAddr:1798
*/
void method6040() {
// instr:"ldr"
// COPY
// opcode=1 seq=0 out=reg(r0) inputs=[ram(0x17d0)]
this.reg.setR0(this.mem.readInt(6096));
// instr:"mov"
// COPY
// opcode=1 seq=0 out=reg(sp) inputs=[reg(r0)]
this.reg.setSp(this.reg.getR0());
// instr:"ldr"
// COPY
// opcode=1 seq=0 out=reg(r0) inputs=[ram(0x17d4)]
this.reg.setR0(this.mem.readInt(6100));
// instr:"ldr"
// COPY
// opcode=1 seq=0 out=reg(r1) inputs=[ram(0x17d8)]
this.reg.setR1(this.mem.readInt(6104));
// instr:"ldr"
// COPY
// opcode=1 seq=0 out=reg(r2) inputs=[ram(0x17dc)]
this.reg.setR2(this.mem.readInt(6108));
// instr:"movs"
// COPY
// opcode=1 seq=0 out=reg(r3) inputs=[const(0x0)]
this.reg.setR3(0);
// INT_SLESS
// opcode=13 seq=1 out=reg(tmpNG) inputs=[reg(r3), const(0x0)]
// INT_EQUAL
// opcode=11 seq=2 out=reg(tmpZR) inputs=[reg(r3), const(0x0)]
// COPY
// opcode=1 seq=3 out=reg(ZR) inputs=[reg(tmpZR)]
this.reg.setZR(this.reg.getTmpZR());
// COPY
// opcode=1 seq=4 out=reg(NG) inputs=[reg(tmpNG)]
this.reg.setNG(this.reg.getTmpNG());
// instr:"b"
// BRANCH
// opcode=4 seq=0 out=<none> inputs=[ram(0x17ac)]
instCount += 7;
}
比如说这段,我静态翻译到java,希望通过副作用展开,外设操作内联,和jvm获得一个高速的模拟mcu,但是到这里,第一个函数起始sp就卡住了,因为b,应为这个b是arm m0的b,所以它是无条件跳转,目标呢?目标是一个ram地址,可ram在静态翻译阶段不存在。
- md写文章真有用,对于18,我为什么不写个反射留在这里呢?让运行时动态寻找这个方法。只要我把整个固件分段翻译成方法,只要有这个目标方法。
- 实际上aot没有意义,graalvm的truffle能让我用jvm 执行pcode和java写的mcu外设,其解释执行的速度是我优化aot一辈子都赶不上的。
- 为啥不写个qemu for apm32呢?我写过,但是qemu不好,qmu是个数十年之久的庞大c项目。换言之就是个屎山,即使用qemu的内核去实现模拟mcu它很快很快很快很快也不好,没有人愿意在没有十万月薪的情况下为qemu写代码,调试。
- 所以最好的技术路径就是sleigh翻译成pcode——》graalvm truffle执行《——》java实现外设《-——》与ng_spice联合仿真。
- 最好的就是最差的,要想和ng_spcie联合仿真至少要读上百页纯英文的pdf,更别说各种诡异的CPP报错了。
- 即使有d_progess来和ng_spice联合仿真,那会很慢,很慢。
- 次要好的办法就是兼容spice语法,用graalvm truffle执行spcie,把mcu和电路放进一个jvm里,然后发动相信的力量相信c2,相信jvm。
- 25比23更糟糕,兼容spice吗?那工作量和难度很大了。
- 我大致调研过所有能仿真mcu的开源模拟器,无外乎qemu,unicorn也是qemu的,只是精简了。所有的具有mcu执行能力的电路仿真模拟器几乎都是qemu,可能说对于低主频的8bitmcu直接引用库或者手动实现了一个简单的模拟器,但是对于arm32这种级别,所有人不约而同的都选择了qemu。
- graalvm的truffle真鸡儿难学,资料还少。
- 副作用展开和外设操作内联的意思是:
mcu固件:给xx设置1以启动xx。
展开后:直接启动xx。
不再去对寄存器值响应,而是直接将寄存器读写视作操作指令去操作内存。
mcu固件:叽里咕噜处理usart,做完准备发字节xx。
展开后:发字节xx。
- 我觉得我的29写的不够好,算了反正没指望有人看懂。
- 人们都说不能闭门造车,所以,看到这里的你觉得写个模拟器有意义吗?