《在 APM32F427 上移植 LVGL 的新方法》在 F427 上把通用 MIPI 驱动这条路跑通了。这篇换到 G32R501,除了实现 MIPI 驱动外,也在同一块屏上把传统 flush_cb 一起实现了。实测对比了两种移植方法在 render 和 flush 方面的效率。
另外,LVGL 的软件绘制单元(src→draw→sw)里是支持 arm2d 也就是 Helium ,本实验也对这个特性进行了实测对比。
LVGL 本身不多展开,用的是 v9.6.0,示例是源码里的 lv_demo_benchmark。
实测对象
- 开发板:G32R501 EVAL评估板
- 芯片:G32R501,Cortex-M52,只用 CPU0
- 屏幕:
- 基于 ST7789 的 TFT LCD,
- 分辨率 240×320
- SPI 接口
- RGB565 像素格式
- 接线:
- SCLK: GPIO9
- MOSI: GPIO8
- CS: GPIO11
- D/C: GPIO30
- RST: GPIO33
- 背光控制: GPIO37
- 其他关键参数
- 时钟:SYSCLK 240 MHz,LSPCLK 120 MHz
- SCLK 按最大频率 LSPCLK/4:30 MHz
- SPI传输:DMA,命令 8 位,像素 16 位。CS 用 GPIO
- 绘制缓冲:SRAM2 上 16 行,7680 字节,
LV_DISPLAY_RENDER_MODE_PARTIAL
两条移植线路
如文章开头所述,本实验采用 MIPI 驱动 和 传统 flush_cb 两种方式。绘制缓冲、DMA、时钟是同一套,差别在窗口命令。
面板初始化放在 ST7789_PanelInit() 里,与 LVGL 无关。顺序是硬件复位、SLPOUT、MADCTL = 0x00、COLMOD = 0x05,然后电源、伽马等,最后 DISPON。
传统移植
显示对象自己建,刷新回调也自己写,关键代码:
ST7789_PanelInit();
disp = lv_display_create(240, 320);
lv_display_set_flush_cb(disp, Lvgl_TraditionalFlush);
lv_display_set_buffers(disp, buf, NULL, sizeof(buf), LV_DISPLAY_RENDER_MODE_PARTIAL);
void Lvgl_TraditionalFlush(lv_display_t * disp, const lv_area_t * area, uint8_t * px_map)
{
uint16_t w = (uint16_t)(area->x2 - area->x1 + 1);
uint16_t h = (uint16_t)(area->y2 - area->y1 + 1);
ST7789_FlushArea((uint16_t)area->x1, (uint16_t)area->y1, w, h,
(const uint16_t *)px_map, (uint32_t)w * h);
lv_display_flush_ready(disp);
}
ST7789_FlushArea 里,CASET 和 4 个地址字节、RASET 和 4 个地址字节,每一次都是 CS 拉低 → 写 → CS 拉高。RAMWR 和后面的像素放在同一次 CS 里。
基于 MIPI 的移植
lv_conf.h 打开 LV_USE_GENERIC_MIPI。内置的 lv_st7789.c 我没有用,它的初始化对不上这块屏(这个可以看之前的文章),这里简单回顾:
应用只提供两个回调。send_cmd 发一条命令和它的参数,CS 操作一次。这里不要调用 lv_display_flush_ready。send_color 收到的是 RAMWR 加像素,发完再 flush_ready。
ST7789_PanelInit();
disp = lv_lcd_generic_mipi_create(240, 320, LV_LCD_FLAG_NONE,
Lvgl_MipiSendCmd, Lvgl_MipiSendColor);
lv_lcd_generic_mipi_send_cmd_list(disp, s_mipiInit);
lv_display_set_buffers(disp, buf, NULL, sizeof(buf), LV_DISPLAY_RENDER_MODE_PARTIAL);
刷新时驱动(MIPI驱动)自己算窗口,分三次回调:CASET,RASET,然后 RAMWR 加像素。前两次走 send_cmd,最后一次走 send_color。
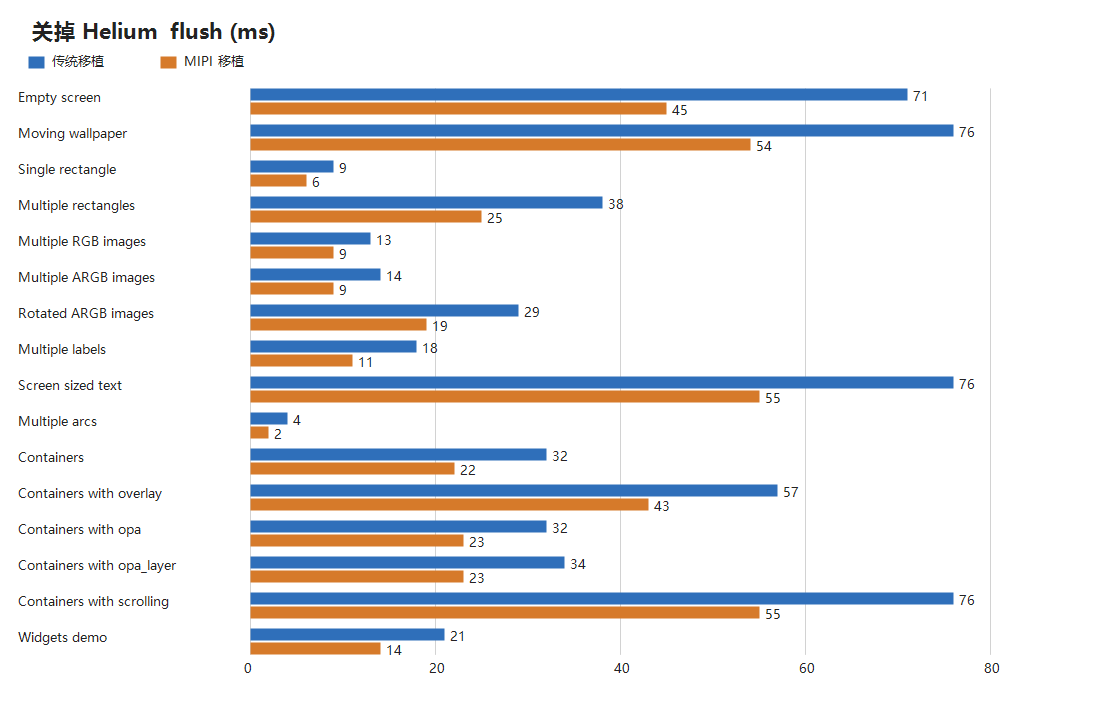
蓝框是传统移植,橙框是 MIPI。像素通过 DMA 传输,差在窗口命令如何分组(控制)。
实测数据及分析
下面这组 Helium 关着。每个组合冷启动跑一遍 lv_demo_benchmark。
串口输出有 HELIUM off,SCLK 30000000 等关键喜喜。
| 项目 | 传统 | MIPI |
|---|
| 整轮用时 | 69402 ms | 69710 ms |
| CPU | 94% | 93% |
| fps | 17 | 19 |
| render | 39 ms | 40 ms |
| flush | 37 ms | 25 ms |
| SPI | 15.28 Mbps,占 30 MHz 的 50.9% | 21.83 Mbps,占 30 MHz 的 72.8% |
render 两列几乎相同。细节数据中旋转图都是 70 ms,整屏文字 278 ms 和 292 ms,CPU 已经吃满。不同的移植方式只是影响了数据传输,并没有调整软件渲染,所以 fps 变化不大 只从 17 升到 19。
差距在 flush:16 个场景里,MIPI 都更短。
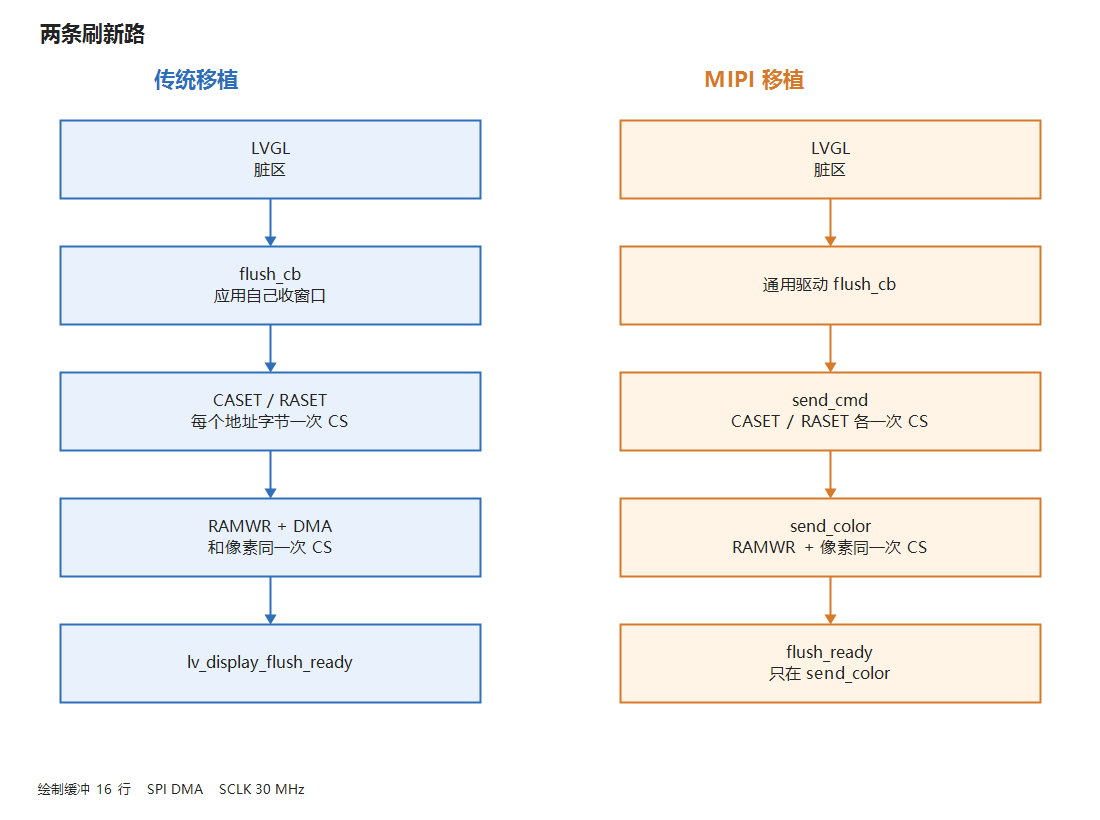
蓝条是传统,橙条是 MIPI,单位毫秒。
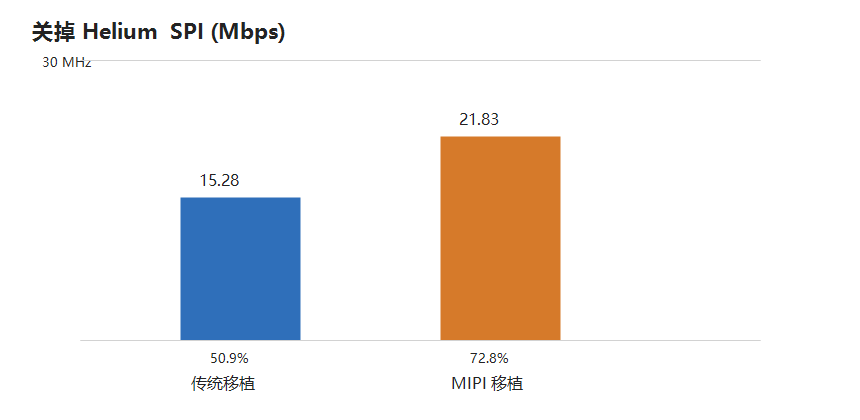
同样 70 秒左右的整轮用时里,MIPI 多送了约 629 万字节,用时还少 4.4 秒。有效速率高大约 43%。
原因就在上一张流程图里。绘制缓冲只有 16 行,大约一帧的 6.7%,一帧要刷二十次上下。传统路径每次先把片选切换十来下,再送像素。MIPI 把列地址收成一次,行地址再收成一次。片选来回被放大以后,同样的 30 MHz,MIPI 更接近线速率。
加速渲染
LVGL 源码里,可以看到 arm2d 这个功能(或者特性吧,原谅我贫乏的词汇积累),可以参考官方说明 或者 百问网翻译 。
G32R501 是 Cortex-M52,核上带 MVE,也就是 Helium。可以在 LVGL 里使用。下一步我们试试 Helium 的加速效果。我测试时使用的 keil MDK 自带的 armclang 用 -mcpu=cortex-m52+cdecp0 编译参数。编译器会定义 __ARM_FEATURE_MVE,实际的值串口打出来是 3。
怎么打开
lv_conf.h 里两处:
#define LV_USE_NATIVE_HELIUM_ASM 1
#define LV_USE_DRAW_SW_ASM LV_DRAW_SW_ASM_HELIUM
工程里还要加两个文件:lv_blend_helium.S,lv_draw_buf_convert_helium.c。LV_USE_DRAW_ARM2D_SYNC 保持 0,也就是使用 同步模式,而不是 异步模式。
如果正常,串口会打印:
HELIUM MVE 3, native blend asm on
为什么要和 C 混着用
最开始的实验中,全部的绘图都由 arm2d 负责。实测发现字符/图形存在局部是黑块,运行 benchmark 中途进入 Fault。一直未能找到原因。后来借助 AI 分析发现 Helium 混合内核要按 8 个像素一拍来写。宽度不是 8 的倍数时,它仍会把这一拍写完,多出来的字节落到下一块内存上。也就是会写到其他图形缓存区域,甚至是引发 Fault。解决方法是增加判断,在 lv_blend_helium.h 里:
static inline bool lv_helium_blend_supported(int32_t w, int32_t h, const void * dest)
{
if(w <= 0 || h <= 0 || w > 1024 || h > 320) return false;
if((w & 7) != 0) return false;
if(((lv_uintptr_t)dest & 1u) != 0u) return false;
return true;
}
返回 false 时,包装函数返回 LV_RESULT_INVALID,LVGL 改用 C 来画这一条。宽 240 的整行可以进汇编;小矩形、文字笔画经常进不去转由 C 负责画。
Helium 加速效果实测
其它条件和上一节相同,只把 Helium 打开。串口输出关键内容: HELIUM MVE 3, native blend asm on。实测数据统计:
| 项目 | 传统,关 | 传统,开 | MIPI,关 | MIPI,开 |
|---|
| 整轮用时 | 69402 ms | 69583 ms | 69710 ms | 69721 ms |
| CPU | 94% | 93% | 93% | 94% |
| fps | 17 | 19 | 19 | 17 |
| render | 39 ms | 40 ms | 40 ms | 38 ms |
| flush | 37 ms | 25 ms | 25 ms | 40 ms |
| SPI | 15.28 Mbps,50.9% | 21.84 Mbps,72.8% | 21.83 Mbps,72.8% | 14.13 Mbps,47.1% |
我原来以为 Helium 能把 render 拉开一截,实际平均只变化了 12 ms。整轮用时仍是场景表排好的 70 秒,fps 一边加 2,一边减 2。
分场景里,大部分开关前后差在 2 ms 以内,差距相对明显的是这三个场景:
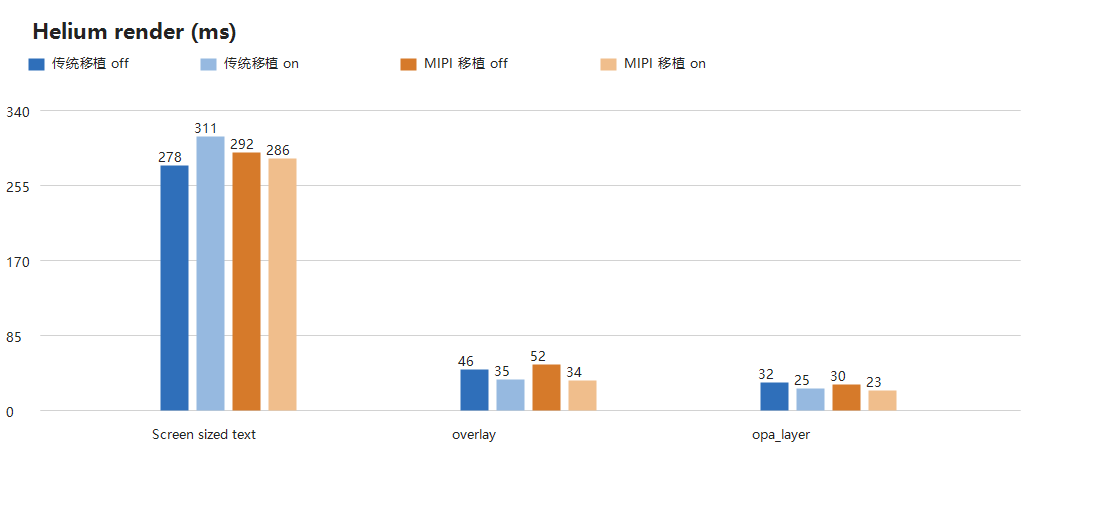
深色是关掉,浅色是打开,单位毫秒。overlay 和 opa_layer 两边都少了 7 到 18 ms,宽 240 的色块能进内核。整屏文字只在 MIPI 上少 6 ms,传统上从 278 ms 增到 311 ms。省下的和多出来的对上了,平均值就停在原地。
flush 也有变化,两个 target 方向相反。四组日志里,每次刷新的像素都在 6900 字节上下,30 MHz 下纯移位大约 1.84 ms。快的两组每次总时间约 2.55 ms,慢的两组约 3.62 ms 和 3.91 ms。
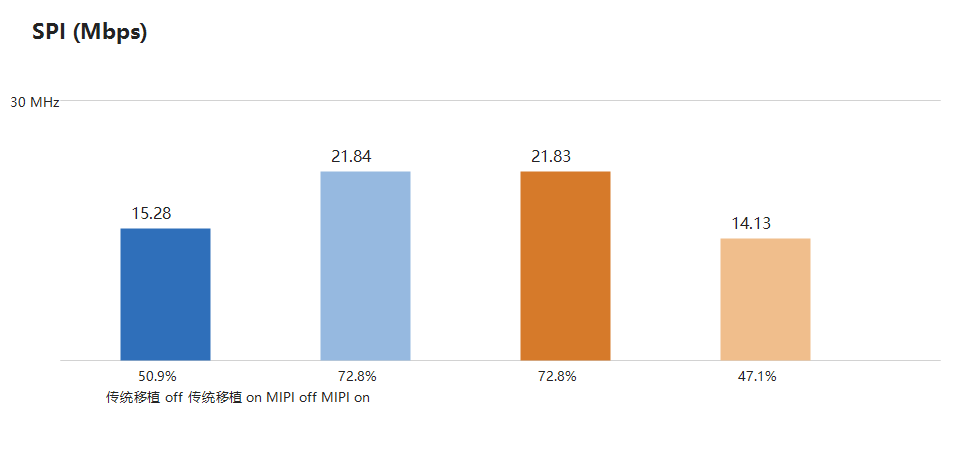
传统的总线利用率从 50.9% 升到 72.8%,MIPI 从 72.8% 降到 47.1%。渲染侧少掉的几毫秒,被刷新侧吃回去了。
从结果来看,Helium 加速效果不明显,甚至在传输效率很高的情况下还会拖后腿。原因其实上面已经提到:Helium 混合内核要按 8 个像素一拍来写,当宽度不是 8 的倍数时转为 C 混合,频繁的判断/切换C混合,拉低了整个渲染流程,当尺寸小的图形/文字需要渲染时,这个影响会被放大;传输效率低,整屏刷新时,Helium 才能发挥最大作用。
—— “钱用在刀口上才好,若用在刀背上,岂不是白填在里头?”
小结
其实没啥好总结的了,就两句话:
- 优先使用 MIPI 移植,能最大程度优化数据传输的效率。
- Helium 在 LVGL 里能发挥的作用有限,这个活还得专用的加速器来承担,例如
STM32 DMA2D, NXP G2D GPU等。